Як потрапити в рекомендації ШІ: дослідження 960 відповідей ChatGPT, Gemini, Claude і Perplexity
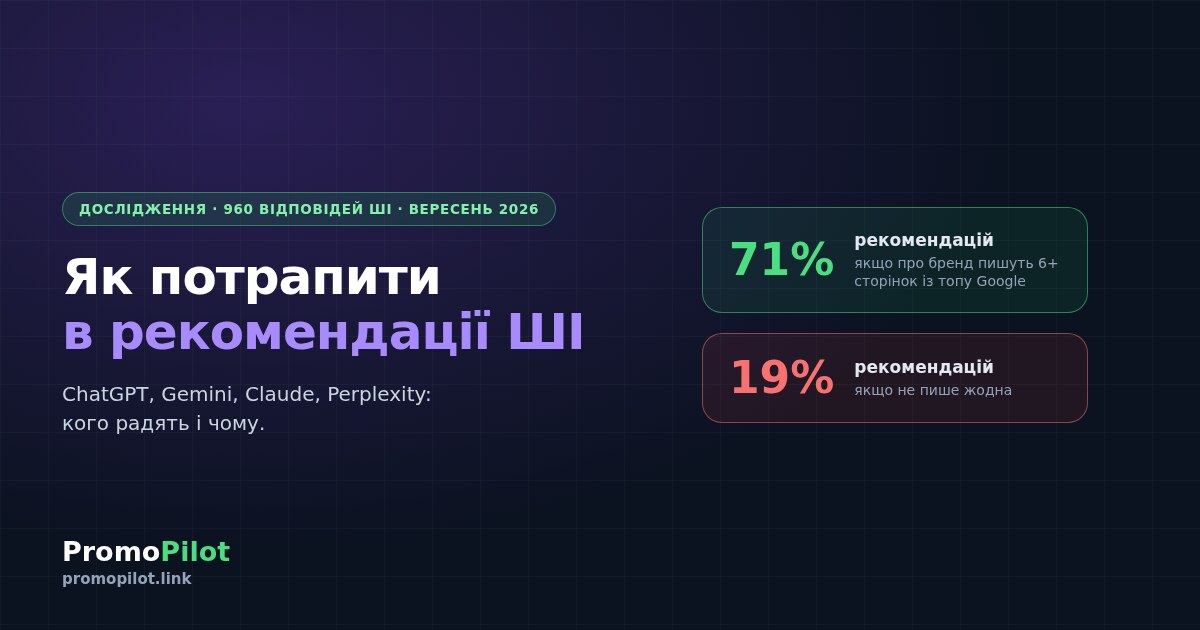
Коли людина питає ШІ, який сервіс обрати, модель називає чотири-шість брендів. Ми поставили 48 таких запитань чотирьом моделям по п'ять разів, зібрали 960 відповідей і 2 536 сторінок-джерел і порівняли їх із видачею Google. Головний висновок: бренд, про який пишуть шість і більше сторінок із топу Google, рекомендують у 71% відповідей, а не згаданий ніде — у 19%. Розбираємо, які сторінки моделі беруть у джерела, чим вони відрізняються в ChatGPT і Gemini, і даємо протокол із семи кроків.
Коли людина питає ChatGPT, який сервіс чи товар обрати, модель називає чотири-шість брендів. Решти для цієї людини просто не існує. Ми поставили чотирьом моделям 48 таких запитань по п'ять разів кожне, зібрали 960 відповідей, завантажили 2 536 сторінок, на які вони посилалися, і порівняли з видачею Google. Коротка відповідь на запитання із заголовка: ШІ рекомендує тих, про кого пишуть інші, на сторінках, які він зараз читає. Нижче — наскільки сильно це працює, як у якої моделі, і що конкретно зробити, щоб до цих відповідей потрапити.
Це продовження нашого матеріалу про те, як потрапити у відповіді ШІ. Там ішлося про технічний доступ: боти, robots.txt, індексація. Тут — про наступний крок: сайт уже читають, але чомусь не радять.
Як ми міряли
48 комерційних запитань на кшталт «який X кращий» у восьми категоріях: софт для бізнесу, електроніка, фінанси, подорожі, здоров'я, онлайн-сервіси, товари для дому та гемблінг. Формулювання — як їх набирає звичайна людина, англійською: ринок США та міжнародний.
Чотири моделі, на яких працюють наймасовіші ШІ-помічники: GPT-5.4 (ChatGPT), Gemini 3.8 Flash, Claude Sonnet 5 і Perplexity Sonar Pro. У кожної увімкнений її власний вебпошук, без системних підказок — запитання йшло рівно так, як його поставила б людина. Кожне запитання кожній моделі — п'ять разів, разом 960 відповідей, жодного збою.
З кожної відповіді ми витягли список рекомендованих брендів і зіставили кожен бренд із його офіційним доменом — це та одиниця, яка цікавить власника сайту. Для тих самих 48 запитів зняли першу десятку Google (США, англійська мова) і завантажили всі сторінки: і процитовані моделями, і ті, що стоять у топі. Завантажити вдалося 92% із 2 536.
Позиції в ШІ не існує — є частота
Перше, що варто зрозуміти, перш ніж щось «просувати»: те саме запитання, поставлене тій самій моделі двічі, дає різні списки. Це давно помітили: дослідження SparkToro на початку 2026 року показало, що ChatGPT та ШІ-огляди Google повертають однаковий список брендів менш ніж в 1% повторів, а той самий список у тому самому порядку — менш ніж у 0,1%.
У нас збіг вищий — від 14% у ChatGPT до 26% у Perplexity. Різниця пояснювана: ми зводили продукти до брендів («Sony WH-1000XM5» і «Sony WH-1000XM6» — це один бренд Sony), а SparkToro порівнював списки конкретних товарів. Але головне в іншому. Бренд номер один збігається у 80–95% повторів. Ядро списку стійке, хвіст — лотерея.
Звідси випливають дві практичні речі. По-перше, перевірка «спитав один раз, мене немає» нічого не означає — потрібно щонайменше п'ять прогонів на запит. По-друге, міряти має сенс не місце в списку, а частку відповідей, у які ви потрапляєте. У кожної моделі за кожним запитом є стійке ядро: 4–6 брендів, які з'являються в трьох прогонах із п'яти й частіше. Мета — потрапити в це ядро.
І ще одне спостереження, яке заощаджує багато сил: ядра різних моделей майже не збігаються. За медіанним запитом у ядро хоча б однієї моделі потрапляє 9 брендів, а в ядро всіх чотирьох одразу — лише 2. Це 21,5%. Кожна модель — окремий канал зі своїми джерелами, і присутність в одному не гарантує присутності в іншому.
Дві дороги до рекомендації: пам'ять і пошук
Вебпошук був увімкнений у всіх чотирьох моделей, але рішення, шукати чи ні, модель ухвалювала сама. І тут різниця виявилася принциповою.
Gemini у 78% випадків відповідав з пам'яті, не відкривши жодного джерела. ChatGPT і Perplexity шукали завжди, Claude — майже завжди. Це означає, що до рекомендації ведуть дві різні дороги, і працюють вони з різною швидкістю.
Пам'ять — те, що потрапило в навчання моделі: багаторічна відомість бренду, кількість згадок в інтернеті на момент збору даних. Цей важіль повільний: сьогоднішня робота відобразиться у відповідях лише в наступних версіях моделей. Пошук — те, що модель знаходить і читає просто зараз. Цей важіль швидкий: сторінка, опублікована й проіндексована цього тижня, може потрапити у відповідь уже наступного.
Добра новина в тому, що обидві дороги ведуть через одне й те саме місце — чужі сторінки про вашу категорію. Їх читає пошук, із них свого часу збиралося і навчання.
Головний важіль: про вас мають писати інші
Це центральний результат дослідження. Для кожного бренду ми порахували, на скількох сторінках із першої десятки Google за тим самим запитом він згадується, — не рахуючи сайту самого бренду. І зіставили з тим, як часто цей бренд рекомендують.
Залежність монотонна і сильна. Бренд, про який не пише жодна сторінка з топу, отримує рекомендацію в середньому в 19% відповідей. Бренд, згаданий на шести сторінках і більше, — у 71%. Серед перших лише кожен десятий входить у ядро — рекомендується хоча б у половині відповідей. Серед других — три з чотирьох.
Ми свідомо брали сторінки з видачі Google, а не ті, що процитували самі моделі. Інакше вийшло б замкнене коло: модель цитує сторінку, бо вже вирішила рекомендувати бренд, а ми «виявляємо», що бренд є на процитованих сторінках. Топ Google від моделей не залежить — це зовнішній список сторінок, які вважаються найкращими за запитом.
Які саме сторінки читають моделі, видно з джерел, на які вони посилаються.
У Claude, Perplexity і Gemini основне джерело — добірки «найкращих»: статті на кшталт «10 найкращих менеджерів паролів у 2026 році». На них припадає від 55% до 78% усіх посилань. ChatGPT влаштований інакше: 62% його посилань ведуть на сайти самих брендів. Він збирає список з оглядів, а потім звіряє ціни, тарифи та функції на офіційних сайтах. Це важливо, і ми повернемося до цього нижче.
Reddit і YouTube, всупереч поширеній думці, помітні лише в Gemini: 9% і 7% його джерел. У трьох інших моделей Reddit — менше 1%. Платформи відгуків на кшталт G2, Capterra і Trustpilot — близько 1% у всіх. Застереження: наші запити — комерційні запитання «що краще», а дослідження, де Reddit виходить у лідери, часто міряють інші типи запитань — поради, особистий досвід, порівняння «що обрати мені». Для рекомендацій у чистому вигляді редакційні добірки важливіші.
Які сторінки ШІ бере в джерела
Якщо головний шлях у рекомендації — сторінки-добірки, наступне запитання: які з них моделі обирають. Ми порівняли редакційні сторінки з топ-10 Google за одними й тими самими запитами: 121 сторінку процитувала хоча б одна модель, 118 — жодна. Усі вони стоять у першій десятці, тобто позиція в Google тут зрівняна.
Різниця за кожною ознакою в один бік. Процитовані сторінки частіше оформлені як добірка (84% проти 53%) і більш ніж удвічі частіше містять поточний рік у заголовку (69% проти 31%). Їх частіше оновлюють: 56% оновлені за останні 90 днів проти 28%, медіана від останнього оновлення — 30 днів проти 67. У них частіше зазначено автора, частіше є таблиця порівняння та розмітка FAQPage або ItemList. І вони довші: медіана 4 489 слів проти 2 013, 13 підзаголовків другого рівня проти 8.
Це кореляції, а не рецепт: з них не випливає, що доданий у заголовок рік сам по собі приведе сторінку у відповіді. Але всі ознаки вказують в один бік — моделі віддають перевагу свіжим, докладним, структурованим порівнянням зі зрозумілим автором. Якщо ви публікуєте власні порівняння, саме так їх і варто робити.
Окремо про зв'язок із Google. Сторінки з позицій 1–6 цитує хоча б одна модель у 45–47% випадків, з позицій 7–10 — у 36%. Але кожна модель окремо бере з топ-10 Google лише від 8% (Gemini) до 32% (Perplexity) сторінок. А з усіх посилань, які наводять моделі, у топ-10 Google лежить лише 7–21%. ШІ-пошук — це не перша сторінка Google. ChatGPT під час пошуку багато в чому спирається на індекс Bing, і сайт, якого майже немає в Bing, ChatGPT знайти не зможе, хоч як добре він стояв би в Google. Ми перевірили це на собі.
Власний сайт: що він робить і чого не робить
У відповідях із пошуком сайт самого бренду опиняється серед джерел у 23% рекомендацій і у 35% головних рекомендацій. Тобто здебільшого модель рекомендує бренд, навіть не відкриваючи його сайт, — на підставі чужих сторінок.
Але власний сайт має дві важливі функції. Перша: ChatGPT звіряє на ньому факти, і те, що там написано, моделі переказують майже дослівно. Ми бачили це на собі: усі чотири моделі описали наш сервіс словами з нашого ж сайту, аж до цифр. Якщо на сайті немає чіткої відповіді, хто ви, для кого, скільки коштуєте і чим відрізняєтеся, модель візьме її в когось іншого.
Друга: бренди, чий власний сайт стоїть у топ-10 Google за тим самим запитом, рекомендують у середньому у 63,5% відповідей, решту — у 29,6%. Тут знову працює відомість бренду, тож це не чистий ефект. Але сайт, який сам ранжується за «найкращий X», — це сигнал і для пошуку моделей, і для авторів добірок.
Перевірили на собі
У серпні сервіс Ahrefs Brand Radar показував у нас нулі за всіма ШІ-платформами. Перша гіпотеза була очевидною — боти заблоковані. Логи сервера її спростували: GPTBot, ClaudeBot і PerplexityBot доходили до сайту. Справжня причина знайшлася в Bing: у його індексі було 2 сторінки з 852, а пошук ChatGPT багато в чому спирається на Bing. Ми підключили IndexNow — протокол, через який сайт сам повідомляє Bing та іншим пошуковикам про нові сторінки. Зараз за 15 брендовими запитами у видачі на рушії Bing є щонайменше 37 різних наших сторінок.
Після цього ми поставили ті самі запитання про себе. За брендовим запитом «що таке PromoPilot і чи вартий він того» нас знайшли й описали всі моделі в усіх 12 відповідях. Claude і Perplexity послалися на 11–14 наших сторінок. А за трьома загальними запитаннями про нашу категорію — «найкращий сервіс багаторівневих посилань», «чим автоматизувати лінкбілдинг», «де замовити посилання для казино» — нас не назвала жодна модель у жодній із 36 відповідей.
Це і є головний висновок статті на живому прикладі. Індексація та відкритий доступ — необхідна умова: без них вас немає навіть за вашою назвою. Але рекомендацію за загальним запитом дають не вони, а присутність у чужих добірках, яких про нас поки мало. Саме над цим ми зараз і працюємо.
Окремо для iGaming: формулювання вирішує
Гемблінг-запити ми включили навмисно — це ніша, де багато хто очікує відмов. Їх не було: жодна модель не відмовилася відповідати на жоден із 120 гемблінг-запитів. Але склад рекомендацій сильно залежав від формулювання.
| Запит | Кого називали найчастіше (разів із 20 відповідей) |
|---|---|
| Найкраще онлайн-казино для гравців зі США | BetMGM 18, DraftKings 17, FanDuel 16, Caesars 15 |
| Найкраще крипто-казино | BitStarz 14, Stake 12, BC.Game 9 |
| Казино з найшвидшими виведеннями | DraftKings 19, FanDuel 17, BetRivers 17, BetMGM 15, Stake 9 |
| Найкращий покерний сайт | PokerStars 20, GGPoker 15, WSOP 14 |
На запитання про США моделі називають лише операторів із ліцензією штатів і обов'язково застерігають, де гра легальна. На запитання про крипто-казино — зовсім інший набір брендів, що працюють поза американською ліцензією. Практичний висновок для операторів: питання не в тому, «чи рекомендує ШІ казино», а в тому, під які формулювання ваш бренд узагалі підходить. Саме добірки за цими формулюваннями і треба відпрацьовувати.
Протокол: що зробити, щоб ШІ рекомендував ваш сайт
Сім кроків у порядку, в якому їх варто проходити. Перші два прибирають причини, через які вас неможливо знайти в принципі; наступні три працюють на головний важіль; останні два — про те, як не витрачати сили наосліп.
Переконайтеся, що вас можуть прочитати всі чотири пошуки
Google і Bing — різні індекси, і ChatGPT під час пошуку багато в чому спирається на Bing. Перевірте, скільки ваших сторінок видно в DuckDuckGo, чия видача багато в чому будується на Bing, і підключіть Bing Webmaster Tools — там є і звіт про цитування в Copilot. Підключіть IndexNow, щоб нові сторінки потрапляли в Bing швидше, а не чекали обходу тижнями. У robots.txt не закривайте пошукових ботів: OAI-SearchBot, PerplexityBot, Claude-SearchBot. Докладно про це — у попередньому матеріалі.
Напишіть на сайті те, що моделі переказуватимуть
Одна сторінка, яка прямо відповідає: що це, для кого, скільки коштує, чим відрізняється від альтернатив, з якими цифрами. Моделі переказують це майже дослівно, а ChatGPT звіряє на офіційному сайті ціни та функції. Застаріла ціна чи розмите формулювання піде у відповіді в тому самому вигляді.
Складіть список сторінок, які ШІ читає за вашою категорією
Випишіть 10–20 запитів, за якими вас мають рекомендувати: «найкращий X», «найкращий X для Y», «альтернативи Z», «X проти Y». Для кожного зберіть першу десятку Google і джерела, на які посилається Perplexity, — він показує їх просто у відповіді. Сторінки, що повторюються в обох списках, — ваші головні цілі.
Потрапте в ці добірки
Це головний важіль: за нашими даними, перехід від «ніде не згаданий» до «згаданий на 4–5 сторінках» піднімає частоту рекомендації з 19% до 53%. Способи потрапити в добірку давно відомі: написати авторові з даними й тестовим доступом, дати ексклюзивні цифри, підключити партнерську програму, якщо видання на ній працює, стати джерелом для їхніх оновлень. Добірки оновлюють часто — медіана в процитованих сторінок 30 днів від останнього оновлення, — тож вікно відкривається регулярно.
Якщо публікуєте власні порівняння — робіть їх такими, які цитують
Формат добірки, поточний рік у заголовку, таблиця порівняння, зазначений автор, оновлення не рідше ніж раз на квартал, розгорнутий текст із підзаголовком для кожного варіанта, розмітка ItemList або FAQPage. Чесне порівняння, де ви не завжди перші, працює краще за рекламну сторінку: моделі шукають зіставлення, а не самоопис.
Врахуйте різний смак моделей
Якщо для вашої аудиторії важливий ШІ Google, додайте Reddit і YouTube: у Gemini це 16% джерел. Якщо важливий ChatGPT — особливо стежте за своїм сайтом і присутністю в Bing. Для Claude і Perplexity вирішують редакційні добірки. Ядра моделей збігаються лише на 21,5%, тому однією тактикою всі чотири не закрити.
Міряйте частоту, а не позицію
Ставте кожен контрольний запит кожній моделі щонайменше п'ять разів і рахуйте частку відповідей, у яких ви є. Окремо за моделями, раз на місяць, одним і тим самим набором запитів. Позиція в списку й одинична перевірка нічого не кажуть: набір брендів у двох сусідніх прогонах збігається лише у 14–26% випадків.
Де тут посилання
Посилання залишаються частиною картини, але їхню роль варто розуміти правильно. Вони не замінюють присутності в редакційних добірках: модель рекомендує бренд тому, що про нього пишуть, а не тому, що на нього посилаються. Натомість посилання допомагають вашим власним сторінкам — головній, сторінці порівняння, опису продукту — ранжуватися в Google і Bing. А саме звідти пошук моделей бере кандидатів у джерела, і сайт, що стоїть у топі за своїм запитом, рекомендують помітно частіше.
Часті запитання
Чому ШІ рекомендує конкурентів, а не мій сайт?
Найчастіше тому, що про конкурентів пишуть на сторінках, які модель читає, а про вас ні. За нашими даними, бренд, не згаданий на жодній сторінці з топ-10 Google за запитом, рекомендують у середньому в 19% відповідей, а згаданий на шести й більше — у 71%. Спершу переконайтеся, що моделі знаходять вас за назвою, потім працюйте над присутністю в добірках.
Скільки разів треба поставити запитання, щоб зрозуміти, чи рекомендує ШІ мій сайт?
Щонайменше п'ять разів кожній моделі. Те саме запитання дає різні списки: повністю набір брендів збігається лише у 14–26% пар повторів. Стійке лише ядро — бренди, які з'являються у трьох відповідях із п'яти й частіше. Міряйте частку відповідей, де ви є, а не місце в списку.
Чи треба бути в топ-10 Google, щоб ШІ мене рекомендував?
Це допомагає: бренди, чий сайт стоїть у топ-10 за запитом, рекомендують у 63,5% відповідей проти 29,6% у решти. Але це не обов'язкова і не достатня умова. Більшість посилань, які наводять моделі, лежить поза першою десяткою Google, а ChatGPT під час пошуку багато в чому спирається на індекс Bing.
Чи допомагає присутність на Reddit?
Для ШІ Google — так: у Gemini Reddit і YouTube разом дали 16% джерел. У ChatGPT, Claude і Perplexity у наших комерційних запитах Reddit посів менше 1% посилань. Для рекомендацій на кшталт «який X кращий» редакційні добірки в цих моделей важливіші.
Як часто треба оновлювати сторінки, щоб їх цитували?
Орієнтир — не рідше ніж раз на квартал. Серед редакційних сторінок із топ-10 Google процитовані моделями у 56% випадків оновлені за останні 90 днів, непроцитовані — лише у 28%. Медіана від останнього оновлення в перших 30 днів, у других 67.
Чи рекомендує ШІ онлайн-казино?
Так, у нашому замірі жодна з чотирьох моделей не відмовилася відповісти на жоден із 120 гемблінг-запитів. Але набір брендів залежить від формулювання: на запитання про США називають лише операторів із ліцензією штатів, на запитання про крипто-казино називають зовсім інші бренди. Працювати треба з добірками за тими формулюваннями, під які підходить ваш бренд.
Джерела: власне дослідження PromoPilot, вересень 2026 року — 960 відповідей моделей GPT-5.4, Gemini 3.8 Flash, Claude Sonnet 5 і Perplexity Sonar Pro з увімкненим вебпошуком за 48 комерційними запитами, топ-10 Google (США) за тими самими запитами і 2 536 сторінок-джерел. Зовнішні дані: дослідження SparkToro про узгодженість рекомендацій ШІ (січень 2026). Моделі викликалися через API; відповіді в застосунках можуть відрізнятися.