Linki wewnątrz PDF-ów: dlaczego nie widzi ich żaden checker i co naprawdę dają
Google mówi wprost: linki w PDF traktowane są jak linki w HTML, mogą przekazywać PageRank, a nofollow wewnątrz PDF-a postawić się nie da. A jednocześnie zwykłe checkery linków ich nie widzą — szukają kodu HTML, którego ten format nie ma. Analizujemy 489 własnych publikacji w PDF, pokazujemy trzy miejsca, w których link ginie, i dajemy protokół sprawdzania w sześciu krokach.
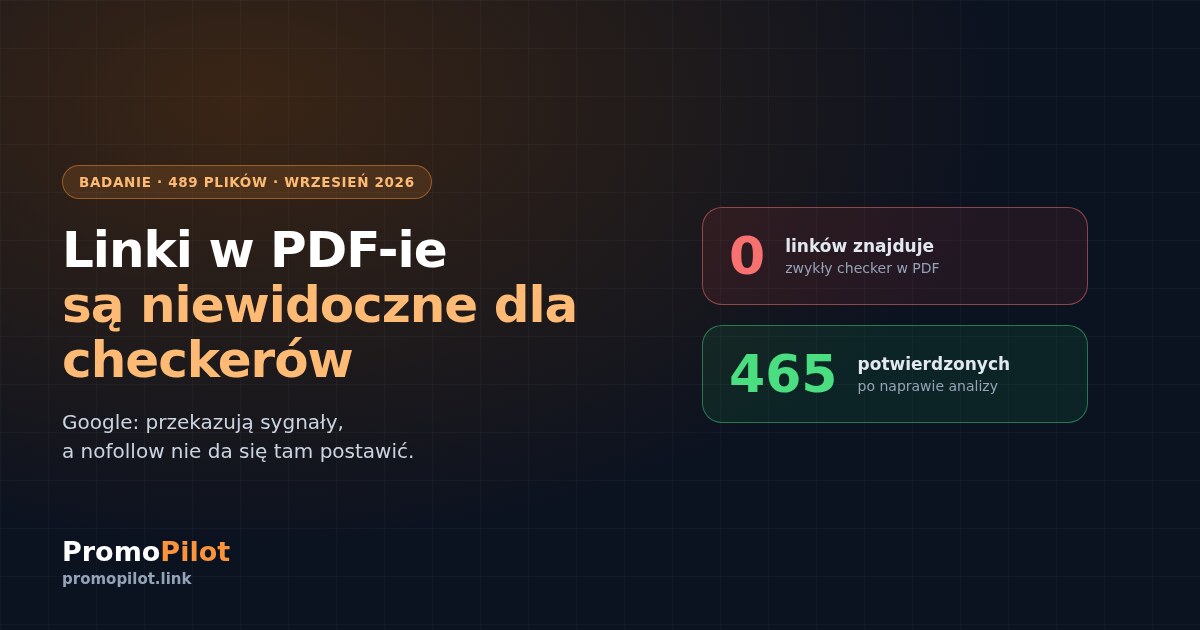
Waszą witrynę wspomniano w raporcie branżowym, katalogu albo poradniku — a wszystko to leży w PDF-ie. Czy taki link się liczy? Google odpowiedział na to pytanie wprost, ale odpowiedź dawno zapomniano, a narzędzia jej nie uwzględniają: żaden zwykły checker linków nie widzi tego, co jest w środku PDF-a. Przeanalizowaliśmy 489 własnych publikacji w tym formacie, znaleźliśmy trzy miejsca, w których link ginie, i pokazujemy, jak sprawdzać takie linki ręcznie.
Co Google mówi o linkach w PDF-ach
Jest oficjalna odpowiedź i jest jednoznaczna:
„Ogólnie linki w plikach PDF są traktowane podobnie jak linki w HTML: mogą przekazywać PageRank i inne sygnały indeksowania, a my możemy za nimi podążać po tym, jak zaindeksujemy plik PDF. Obecnie nie jest możliwe użycie linków nofollow wewnątrz dokumentu PDF".
Google Search Central Blog, „PDFs in Google search results", 1 września 2011Zwróćcie uwagę na drugą połowę cytatu. Wewnątrz PDF-a nie da się postawić nofollow — format po prostu nie ma miejsca, gdzie to zapisać. To znaczy, że każdy link w zaindeksowanym PDF-ie jest domyślnie otwarty, a pytanie „a może tam jest nofollow" w ogóle tu nie powstaje.
Uczciwe zastrzeżenie co do wieku: wpis ma piętnaście lat. To wciąż najbardziej szczegółowa oficjalna wypowiedź Google o PDF-ach i nie została wycofana, ale od 2011 roku sformułowania mogły się zmienić bez ogłoszenia. Część weryfikowalna — o braku nofollow w formacie — od czasu nie zależy: to właściwość samego PDF-a, a nie polityki.
Z tej samej odpowiedzi warto wziąć jeszcze cztery fakty: Google indeksuje PDF-y od 2001 roku; indeksowana jest treść tekstowa, o ile plik nie jest chroniony hasłem; obrazy wewnątrz PDF-a nie są indeksowane; a usunąć PDF z wyników można nagłówkiem X-Robots-Tag: noindex, bo meta tagu wewnątrz pliku nie ma.
Dlaczego tych linków nie widzi żaden checker
Wzięliśmy dwa żywe PDF-y i sprawdziliśmy je na dwa sposoby: zwykłą analizą kodu, tak jak robi to każdy checker linków, i analizą samego formatu.
Wynik jest przewidywalny, gdy zna się budowę formatu, i zupełnie nieoczywisty, gdy się jej nie zna. W PDF-ie nie ma znacznika <a> — struktura dokumentu jest inna. Szukanie <a href> uczciwie zwraca zero, a narzędzie melduje „nie ma linku", choć link jest i da się w niego kliknąć.
Przy okazji potwierdziło się też stwierdzenie Google o nofollow: atrybutów rel w plikach nie znalazł się ani jeden. Nie może ich tam być.
Trzy miejsca, w których link ginie
Nie doszliśmy do tego teoretycznie. U nas samych rozliczanie PDF-ów było zepsute, a analiza pokazała trzy niezależne przyczyny — każda z osobna wygląda na rozsądną decyzję inżynierską.
Pierwsza: parser szuka HTML-a. Druga: sprawdzenie „czy jest na stronie nasz tekst" szuka ciągu w bajtach pliku, a tekst w PDF leży w strumieniach skompresowanych i z zewnątrz go nie widać. Trzecia: sprawdzenie odpowiada „zawartość to nie HTML, czyli to nie strona" i odrzuca plik w całości.
Wynik: z 489 naszych publikacji w PDF system pewnie uznawał za potwierdzone pojedyncze sztuki. Po naprawie analizy potwierdziło się 465, martwych — zero. Pliki przez cały ten czas żyły; ślepe było sprawdzanie.
Jak wydobyć linki z PDF-a
Linki w PDF-ie są przechowywane w adnotacjach typu /URI. W plikach powstałych z wydruku z przeglądarki leżą niemal otwartym tekstem i da się je wyciągnąć bez specjalnych bibliotek:
1. Pobrać plik jak jest, bez analizowania go jako HTML
2. Znaleźć w bajtach konstrukcje postaci /URI (adres)
3. Jeśli nic nie ma — rozpakować strumienie
   (między "stream" a "endstream") i powtórzyć szukanie
4. Osobno sprawdzić nagłówek odpowiedzi:
   czy jest X-Robots-Tag z noindex
Czwarty krok jest nie mniej ważny niż trzy pierwsze. PDF nie ma meta tagu robots, więc jedynym sposobem zamknięcia pliku przed indeksowaniem jest nagłówek odpowiedzi serwera. I jedynym sposobem sprawdzenia tego jest zajrzenie w nagłówki, a nie w zawartość.
Protokół sprawdzania: sześć kroków
Upewnić się, że plik jest wydawany
Poproście o adres i spójrzcie na kod odpowiedzi oraz Content-Type. Normalna odpowiedź to 200 i application/pdf. Jeśli przyszedł HTML, pobraliście stronę-opakowanie, a nie sam plik, i dalsze sprawdzanie nie ma sensu.
application/pdf, a rozmiar pliku przypomina dokument, a nie stronę błędu.Sprawdzić nagłówek X-Robots-Tag
To właśnie tutaj zamyka się PDF przed indeksowaniem. Meta tagu wewnątrz pliku nie ma, więc jeśli w nagłówkach stoi noindex, plik do indeksu nie trafi — a link z niego nic nie da.
noindex tam nie ma.Znaleźć link w adnotacjach
Szukajcie konstrukcji /URI z adresem. Jeśli nic się nie znajdzie, rozpakujcie strumienie i powtórzcie — część plików trzyma adnotacje wewnątrz nich.
Jeśli i potem jest pusto, a w dokumencie link widać gołym okiem — najpewniej to zwykły tekst napisany jako adres, bez aktywnej adnotacji. Takim „linkiem" jest on tylko dla człowieka.
Nie szukać rel — jego tam nie ma
Krok, który oszczędza czas: w PDF nie ma mechanizmu nofollow. Jeśli link w adnotacji jest, a plik jest indeksowalny, pytanie o to, czy jest otwarty, zamyka sama budowa formatu.
Sprawdzić, czy tekst w ogóle da się wydobyć
Google indeksuje treść tekstową PDF-a. Najprostsze sprawdzenie to otworzyć plik i spróbować zaznaczyć oraz skopiować tekst. Jeśli się kopiuje, wyszukiwarka też go odczyta. Jeśli to obrazek strony, treść opiera się na rozpoznawaniu i nie warto na nią liczyć.
Uzbroić się w cierpliwość
To najmniej przyjemna część. Według naszych danych PDF-y opublikowane w listopadzie i grudniu 2025 roku po raz pierwszy trafiły do indeksu linków zewnętrznego serwisu we wrześniu 2026 — mniej więcej dziewięć miesięcy później.
Zastrzeżenie obowiązkowe: to indeks jednego komercyjnego serwisu, a nie Google, i z jednej obserwacji prawidłowości się nie buduje. Ale rząd wielkości warto trzymać w głowie: tygodnie to tu nie jest jednostka.
Co zobaczyliśmy we własnych danych — i czego nie zobaczyliśmy
Po naprawie rozliczania zestawiliśmy terminy. We wrześniu 2026 indeks linków po raz pierwszy przeszedł po naszych donorach PDF opublikowanych prawie rok wcześniej, a w tym samym oknie sześciu domenom klientów zauważalnie wzrósł wskaźnik autorytetu domeny — z pojedynczych jednostek do 17–21.
Tu trzeba się zatrzymać i powiedzieć to, czego zwykle się nie mówi. To zbieżność w czasie, a nie dowód. Wskaźnik autorytetu to metryka zewnętrznego serwisu, a nie Google, i rośnie dokładnie wtedy, gdy serwis znajduje nowe linki. Związek z pozycjami i ruchem z tego nie wynika.
Najmocniej tę wątpliwość podpiera kontrprzykład z tej samej próby: jedna domena ma szesnaście żywych PDF-ów z linkami — i zerowy ruch. Gdyby mechanika była bezpośrednia, efekt byłby i tam.
Co z tego można wziąć uczciwie: linki w PDF-ach istnieją, są indeksowane i są liczone przez indeksy linków. Na ile wpływają na ranking — z naszych danych nie wynika i twierdzić tego nie będziemy.
Czego nie robić
Krótko
Google mówi wprost, że linki w PDF-ach przekazują sygnały tak samo jak zwykłe i że nofollow wewnątrz PDF-a postawić się nie da. A jednocześnie zwykłe checkery ich nie widzą — szukają kodu HTML, którego w tym formacie nie ma. Znaleźliśmy trzy niezależne miejsca, w których taki link ginie, i niemal wszystkie swoje 489 publikacji w PDF początkowo uznawaliśmy za niepotwierdzone.
Jeśli macie zrobić jedną rzecz: weźcie dowolny PDF, w którym ktoś do was linkuje, i poszukajcie w jego bajtach /URI. Zajmie to minutę, a wynik może się rozejść z tym, co pokazuje wasze narzędzie.
Skanowanie pokaże, co przeszkadza waszym stronom trafiać do indeksu.
Częste pytania
Czy linki z PDF przekazują moc?
Według oficjalnej odpowiedzi Google linki w PDF są traktowane podobnie jak linki w HTML: mogą przekazywać PageRank i inne sygnały indeksowania, a Google może za nimi podążać po zaindeksowaniu pliku. Warunek jest ten sam co dla zwykłych stron: plik musi być dostępny i niezamknięty przed indeksowaniem.
Czy można postawić nofollow w PDF?
Nie. Google wprost wskazuje, że użycie linków nofollow wewnątrz dokumentu PDF nie jest możliwe, i jest to właściwość samego formatu: nie przewidziano w nim miejsca na taki atrybut. W naszych sprawdzeniach nie znalazł się w PDF ani jeden atrybut rel.
Dlaczego checker linków nie widzi linku w PDF?
Ponieważ szuka znaczników, a w PDF ich nie ma — struktura dokumentu jest inna. Linki są przechowywane w adnotacjach typu URI. Dopóki narzędzie nie analizuje samego formatu, będzie zwracać zero niezależnie od zawartości.
Jak zamknąć PDF przed indeksowaniem?
Wyłącznie nagłówkiem odpowiedzi X-Robots-Tag z wartością noindex. Meta tagu robots wewnątrz PDF nie ma, więc znany sposób dla stron HTML tutaj nie działa.
Czy obrazy wewnątrz PDF są indeksowane?
Według tej samej odpowiedzi Google — nie, obrazy wewnątrz PDF nie są indeksowane. Żeby grafiki brały udział w wyszukiwaniu, muszą znaleźć się na zwykłych stronach.
Po jakim czasie pojawi się efekt linku z PDF?
Szybko nie bywa. W naszym przypadku między publikacją plików a ich pierwszym pojawieniem się w indeksie linków zewnętrznego serwisu minęło około dziewięciu miesięcy. To jedna obserwacja, a nie reguła, ale planować warto w miesiącach.
Źródła
Google Search Central Blog, „PDFs in Google search results", 1 września 2011, autor Gary Illyes: traktowanie linków w PDF, brak możliwości nofollow, indeksowanie tekstu, obrazy wewnątrz PDF, zamykanie przez X-Robots-Tag.
Własny pomiar PromoPilot, 24 września 2026: sprawdzenie na żywo publikacji w PDF — porównanie analizy kodu z analizą formatu, kody odpowiedzi i nagłówki.
Własne dane PromoPilot: 489 publikacji w formacie PDF w okresie od 31 października 2025 do 18 września 2026; po naprawie analizy potwierdzono 465, niepotwierdzonych — zero.